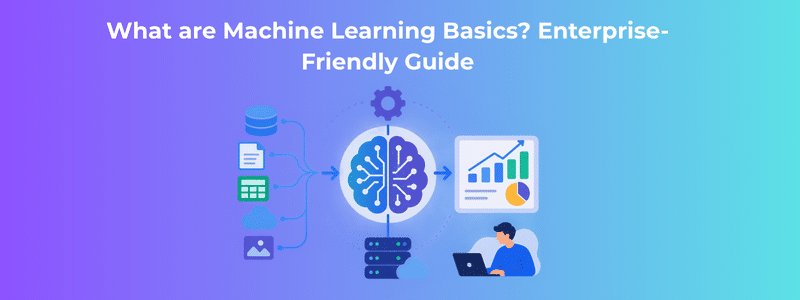
L'apprentissage automatique (ML) n'est plus une technologie expérimentale réservée aux équipes de science des données. En 2026, les entreprises utilisent l'apprentissage automatique pour prévoir la demande, détecter les fraudes, personnaliser l'expérience client, automatiser les décisions, optimiser leurs opérations, identifier les risques et transformer de grands volumes de données métier en informations exploitables.
Pour les organisations qui envisagent d'adopter l'IA, cependant, L'apprentissage automatique ne se résume pas à choisir un algorithme et à l'entraîner à partir de données historiques.. Pour que le machine learning soit couronné de succès en entreprise, il faut allier stratégie commerciale, données de qualité, modèles adaptés, ingénierie logicielle fiable, infrastructure cloud, sécurité, gouvernance et surveillance continue.
Ce guide destiné aux entreprises explique les les bases de l'apprentissage automatique, le fonctionnement de l'apprentissage automatique, les principaux types d'apprentissage automatique, les algorithmes courants, les cas d'utilisation en entreprise, l'architecture de l'apprentissage automatique, le MLOps, les coûts de mise en œuvre, les défis à relever, les considérations en matière de sécurité et les mesures concrètes que les entreprises peuvent prendre pour adopter l'apprentissage automatique en 2026.
Qu'est-ce que l'apprentissage automatique ?
L'apprentissage automatique est une branche de l'intelligence artificielle qui permet aux systèmes logiciels de apprendre des modèles à partir des données et utiliser ces modèles pour établir des prévisions, effectuer des classifications ou prendre des décisions sans avoir été explicitement programmé pour chaque scénario possible.
Les logiciels traditionnels suivent généralement des règles prédéfinies :
Entrée → Règles/Logique → Sortie
Un système d'apprentissage automatique fonctionne différemment :
Données → Algorithme d'apprentissage → Modèle entraîné → Prédiction/Décision
Par exemple, un système traditionnel d'identification des transactions suspectes pourrait comporter des règles telles que :
- Signaler les transactions supérieures à $10 000.
- Signaler les transactions provenant d'un pays donné.
- Signaler plus de cinq transactions en l'espace de 10 minutes.
Un système d'apprentissage automatique peut, quant à lui, analyser les données historiques des transactions et mettre en évidence les liens entre les caractéristiques de ces transactions et les transactions frauduleuses précédemment identifiées.
Le modèle qui en résulterait pourrait prendre en compte :
- Montant de la transaction
- Emplacement
- Appareil
- Heure
- Comportement des clients
- Catégorie de commerçant
- Fréquence des transactions
- Tendances historiques
Le modèle peut alors estimer la probabilité qu'une nouvelle transaction soit frauduleuse.
Cette capacité à tirer des enseignements d'exemples historiques rend l'apprentissage automatique particulièrement utile pour les entreprises qui traitent des ensembles de données volumineux, complexes et en constante évolution.
Comment fonctionne l'apprentissage automatique ?
À un niveau élémentaire, l'apprentissage automatique comporte plusieurs étapes.
1. Définir le problème métier
La première étape ne devrait pas consister à choisir un algorithme.
Une entreprise doit tout d'abord définir les objectifs qu'elle souhaite atteindre.
Par exemple:
Peut-on prédire quels clients sont susceptibles de résilier leur abonnement au cours des 30 prochains jours ?
L'objectif métier détermine le type de problème d'apprentissage automatique à résoudre.
2. Collecter des données
Les données historiques pertinentes sont collectées à partir de systèmes tels que :
- Plateformes CRM
- Systèmes ERP
- Sites web
- Applications mobiles
- Bases de données transactionnelles
- Appareils IoT
- Systèmes d'assistance à la clientèle
- Plateformes marketing
- Entrepôts de données
- Lacs de données
3. Préparer les données
Les données brutes d'entreprise sont rarement prêtes à être utilisées immédiatement pour l'entraînement d'un modèle.
Il peut contenir :
- Valeurs manquantes
- Enregistrements en double
- Valeurs incorrectes
- Formats non uniformes
- Valeurs aberrantes
- Caractéristiques non pertinentes
- Échantillons biaisés
La préparation des données devient donc un élément essentiel du projet d'apprentissage automatique.
4. Sélectionner et entraîner un modèle
Un algorithme d'apprentissage automatique adapté est sélectionné et entraîné à l'aide de données historiques.
5. Évaluer le modèle
Le modèle est testé à l'aide de données qu'il n'a jamais vues auparavant.
6. Déployer le modèle
Une fois validé, le modèle peut être intégré à une application d'entreprise ou à un processus métier.
7. Suivre et améliorer
L'apprentissage automatique ne s'arrête pas forcément au stade du déploiement.
Les données concrètes évoluent. Le comportement des clients évolue. Les marchés évoluent. Les produits évoluent.
Le modèle doit donc faire l'objet d'un suivi continu et, le cas échéant, être réentraîné.
De la même manière, AWS décrit le cycle de vie du machine learning comme s'articulant autour de l'identification des objectifs métier, de la définition du problème, du traitement des données, du développement du modèle, du déploiement et de la surveillance.
Pourquoi l'apprentissage automatique est-il essentiel pour les entreprises ?
La principale valeur ajoutée de l'apprentissage automatique pour les entreprises réside dans sa capacité à transformer de grands volumes de données en prévisions et en intelligence automatisée.
1. Une meilleure prise de décision
L'apprentissage automatique permet d'identifier des tendances qui peuvent être difficiles à détecter manuellement.
Les dirigeants peuvent utiliser des modèles prédictifs pour étayer leurs décisions concernant :
- Demande
- Tarifs
- Stock
- Fidélisation de la clientèle
- Risque
- Marketing
- Planification des effectifs
2. Automatisation des processus
L'apprentissage automatique permet d'automatiser les décisions au sein de flux de travail répétitifs.
En voici quelques exemples :
- Classification des factures
- Détection des fraudes
- Classification des documents
- Hiérarchisation des tickets
- Notation des prospects
- Contrôle qualité
3. Personnalisation
Le Machine Learning permet d'analyser le comportement de chaque client et de générer des recommandations personnalisées.
Les entreprises de commerce électronique peuvent s'en servir pour proposer des recommandations de produits, tandis que les établissements financiers peuvent utiliser des modèles prédictifs pour personnaliser leurs offres client.
4. Efficacité opérationnelle
L'analyse prédictive peut aider les entreprises à identifier les problèmes opérationnels avant qu'ils ne se transforment en problèmes coûteux.
Par exemple, les modèles de maintenance prédictive permettent d'analyser les données relatives aux équipements afin d'estimer à quel moment une intervention de maintenance pourrait s'avérer nécessaire.
5. Réduction des risques
L'apprentissage automatique permet d'identifier des tendances inhabituelles liées à :
- Fraude
- Incidents liés à la cybersécurité
- Risque financier
- Panne d'équipement
- Taux de désabonnement
- Perturbation de la chaîne d'approvisionnement
Apprentissage automatique, IA et apprentissage profond : quelle différence ?
Ces termes sont souvent utilisés de manière interchangeable, mais ils ne sont pas synonymes.
| Technologie | Signification | Exemple |
|---|---|---|
| Intelligence artificielle | Vaste domaine des systèmes de construction capables d'effectuer des tâches liées à l'intelligence | Assistant client basé sur l'IA |
| Apprentissage automatique | Techniques d'IA qui apprennent des modèles à partir des données | Prévision des fraudes |
| Apprentissage profond | Apprentissage automatique basé sur des réseaux neuronaux multicouches | Reconnaissance d'images |
| IA générative | IA capable de générer du nouveau contenu | Génération de texte, d'images ou de code |
L'apprentissage automatique est donc un sous-domaine de l'intelligence artificielle.
L'apprentissage profond est un sous-ensemble de l'apprentissage automatique.
L'IA générative recoupe le domaine de l'apprentissage automatique et utilise couramment des architectures d'apprentissage profond.
Pour les entreprises, cette distinction est importante, car chaque problématique commerciale nécessite des technologies différentes.
Un problème de prévision ne nécessite pas forcément un modèle d'IA générative de grande envergure. Un problème de classification de documents peut être résolu à l'aide d'un apprentissage automatique classique. Une tâche complexe d'analyse d'images peut tirer parti de l'apprentissage profond.
Types d'apprentissage automatique
L'apprentissage automatique peut, de manière générale, être divisé en plusieurs catégories.
1. Apprentissage supervisé
L'apprentissage supervisé utilise des données d'entraînement étiquetées.
Le modèle apprend à partir d'exemples pour lesquels la sortie attendue est déjà connue.
Par exemple:
| Client | Achats précédents | Demandes d'assistance | Battue |
|---|---|---|---|
| A | 12 | 1 | Non |
| B | 2 | 8 | Oui |
| C | 9 | 2 | Non |
Le modèle apprend les relations entre les caractéristiques des clients et leur perte.
Parmi les tâches courantes d'apprentissage supervisé, on peut citer :
- Classification
- Régression
- Prévision
Exemples d'entreprises
- Détection des fraudes
- Prévision du taux de désabonnement des clients
- Évaluation du risque de crédit
- Prévisions de ventes
- Notation des prospects
2. Apprentissage non supervisé
L'apprentissage non supervisé s'applique à des données pour lesquelles aucune étiquette prédéfinie n'est disponible.
L'algorithme cherche à identifier des modèles ou des structures au sein des données.
Parmi les applications courantes, on peut citer :
- Segmentation de la clientèle
- Détection des anomalies
- Regroupement
- Découverte de modèles
Par exemple, une entreprise de commerce électronique pourrait recourir au regroupement par clusters pour identifier des groupes de clients présentant des comportements d'achat similaires.
3. Apprentissage semi-supervisé
L'apprentissage semi-supervisé combine des données étiquetées et non étiquetées.
Cela peut s'avérer utile lorsqu'une entreprise dispose d'un volume important de données, mais que seule une petite partie d'entre elles a été étiquetée manuellement.
Par exemple, une entreprise peut disposer de millions de messages liés au service client, mais ne compter que 50 000 exemples classés manuellement.
Les techniques semi-supervisées peuvent potentiellement tirer parti de ces deux ensembles de données.
4. Apprentissage par renforcement
L'apprentissage par renforcement consiste pour un agent à apprendre par le biais d'interactions avec un environnement.
Le système reçoit des récompenses ou des sanctions en fonction de ses actions.
Parmi les applications potentielles pour les entreprises, on peut citer :
- Optimisation
- Robotique
- Allocation dynamique des ressources
- Optimisation des recommandations
- Contrôle industriel
L'apprentissage par renforcement est plus spécialisé que l'apprentissage supervisé classique et doit être envisagé en fonction du problème métier spécifique plutôt que comme une approche par défaut du machine learning.
Algorithmes courants d'apprentissage automatique
Les entreprises n'ont pas besoin d'utiliser l'algorithme le plus complexe qui soit.
Le choix de l'algorithme approprié dépend du problème, de l'ensemble de données, des exigences en matière de performances et des exigences en matière d'explicabilité.
Régression linéaire
Permet de prédire des valeurs numériques continues.
Exemple:
Prévision du chiffre d'affaires mensuel.
Régression logistique
Souvent utilisé pour la classification binaire.
Exemple:
Ce client va-t-il nous quitter : oui ou non ?
Malgré sa simplicité, la régression logistique peut s'avérer utile lorsque l'interprétabilité est un critère important.
Arbres de décision
Les arbres de décision permettent de faire des prédictions à l'aide d'une série de règles de décision.
Ils peuvent être utiles pour :
- Classification
- Régression
- Analyse des risques
Leur structure peut également être plus facile à expliquer que certains modèles complexes.
Forêt aléatoire
La méthode « Random Forest » combine plusieurs arbres de décision afin d'améliorer les performances prédictives et la robustesse.
Parmi les applications courantes, on peut citer :
- Détection des fraudes
- Classification des clients
- Prévision des risques
- Prévisions commerciales
Gradient Boosting
Les méthodes de « gradient boosting » construisent des modèles de manière séquentielle afin d'améliorer la précision des prédictions.
Parmi les implémentations les plus courantes, on peut citer :
- XGBoost
- LightGBM
- CatBoost
Ces méthodes sont largement utilisées pour les ensembles de données d'entreprise structurés ou sous forme de tableaux.
Machines à vecteurs de support
Les machines à vecteurs de support peuvent être utilisées pour résoudre des problèmes de classification et de régression.
Ils peuvent s'avérer particulièrement efficaces pour certains ensembles de données à haute dimension, même si leur pertinence dépend de la taille et de l'architecture de l'ensemble de données.
Réseaux neuronaux
Les réseaux neuronaux utilisent des couches de calcul interconnectées pour apprendre des modèles complexes.
Ils sont largement utilisés pour :
- Vision par ordinateur
- Traitement du langage naturel
- Discours
- Modélisation des séries chronologiques
- Applications prédictives complexes
Le cycle de vie des principes fondamentaux de l'apprentissage automatique
Pour qu'un projet d'apprentissage automatique en entreprise soit couronné de succès, il doit s'inscrire dans un cycle de vie reproductible.
Étape 1 : Objectif commercial
Définissez le problème en termes commerciaux mesurables.
Étape 2 : Exploration des données
Recenser les ensembles de données disponibles et évaluer leur qualité.
Étape 3 : Formulation du problème
Déterminez si le problème est :
- Classification
- Régression
- Prévisions
- Regroupement
- Détection des anomalies
- Recommandation
- Optimisation
Étape 4 : Ingénierie des données
Nettoyer, transformer et préparer les données.
Étape 5 : Ingénierie des caractéristiques
Identifier et élaborer des données d'entrée utiles pour le modèle.
Étape 6 : Élaboration du modèle
Entraînez et comparez les modèles appropriés.
Étape 7 : Évaluation
Évaluer les performances à l'aide d'indicateurs pertinents.
Étape 8 : Déploiement
Intégrer le modèle aux applications métier.
Étape 9 : Suivi
Écran :
- Précision
- Latence
- Qualité des données
- Dérive
- Infrastructure
- Coût
Étape 10 : Recyclage professionnel
Procéder à un réentraînement lorsque les performances du modèle ou les conditions des données l'exigent.
Les données : le fondement du ML d'entreprise
Les performances de l'apprentissage automatique dépendent fortement de la qualité des données.
Une entreprise peut disposer d'énormes quantités de données tout en ne disposant pas d'un ensemble de données adapté à l'apprentissage automatique.
Parmi les aspects importants à prendre en compte concernant les données, on peut citer :
Exhaustivité des données
Y a-t-il des valeurs importantes qui manquent ?
Cohérence des données
Les mêmes entités sont-elles représentées de manière cohérente d'un système à l'autre ?
Exactitude des données
Ces données reflètent-elles la réalité ?
Actualité des données
Ces informations sont-elles suffisamment à jour pour répondre au problème métier ?
Pertinence des données
Le jeu de données contient-il réellement des informations utiles pour prédire la variable cible ?
Biais des données
Les données d'entraînement reflètent-elles de manière disproportionnée certains groupes ou certains scénarios ?
Des données de mauvaise qualité peuvent conduire à des prévisions peu fiables, quelle que soit la sophistication du modèle.
Formation, validation et tests
Un workflow courant en apprentissage automatique consiste à diviser les données en ensembles de données distincts.
Ensemble de données d'entraînement
Utilisé pour entraîner le modèle.
Ensemble de données de validation
Utilisé pour ajuster les paramètres du modèle et comparer les différentes approches.
Ensemble de données de test
Utilisé pour évaluer le modèle final à l'aide de données non vues auparavant.
Cette séparation permet de réduire le risque de construire un modèle qui se contente de mémoriser ses données d'apprentissage.
Ce problème est connu sous le nom de surapprentissage.
Surajustement et sous-ajustement
Surapprentissage
Un modèle surajusté donne d'excellents résultats sur les données d'apprentissage, mais de mauvais résultats sur les nouvelles données.
Il a en effet appris les exemples d'entraînement plutôt que les modèles sous-jacents généralisables.
Sous-dimensionnement
Un modèle sous-ajusté est trop simple pour permettre de mettre en évidence des relations significatives dans les données.
Le développement du ML en entreprise implique donc de trouver un juste équilibre entre la complexité du modèle et sa capacité de généralisation.
Indicateurs d'évaluation des modèles d'apprentissage automatique
La précision à elle seule ne suffit pas pour tous les projets d'apprentissage automatique.
Précision
Le pourcentage de prédictions correctes.
Utile dans certains problèmes de classification équilibrée.
Précision
Parmi toutes les prévisions positives, combien se sont réellement avérées positives ?
C'est important lorsque les faux positifs ont un coût élevé.
Rappel
Sur l'ensemble des cas positifs réels, combien le modèle en a-t-il identifiés ?
C'est important lorsque le fait de passer à côté d'un cas positif a des conséquences importantes.
Résultats de F1
Allie précision et recouvrement.
Erreur absolue moyenne
Mesure la différence absolue moyenne entre les valeurs prévues et les valeurs réelles.
Courant en analyse de régression.
Erreur quadratique moyenne
Sanctionne plus sévèrement les erreurs les plus graves.
AUC-ROC
Évalue la capacité d'un modèle de classification à distinguer les classes en fonction de différents seuils.
L'indicateur approprié doit être lié à la coût pour l'entreprise des différents types d'erreurs.
Architecture d'apprentissage automatique d'entreprise
Une architecture d'apprentissage automatique d'entreprise type peut comporter les couches suivantes :
Applications d'entreprise
 ↓
Couche API / d'intégration
 ↓
Service d'inférence d'apprentissage automatique
 ↓
Modèle d'apprentissage automatique entraîné
 ↓
Registre des modèles
 ↓
Pipeline d'entraînement
 ↓
Traitement des caractéristiques / des données
 ↓
Lac de données / entrepôt de données
 ↓
Sources de données d'entreprise
Cette architecture s'appuie sur les éléments suivants :
- Gestion des identités et des accès
- Suivi
- Exploitation forestière
- Sécurité
- Gouvernance
- CI/CD
- Automatisation des infrastructures
- Gestion des versions des modèles
L'architecture exacte dépend du type de déploiement du modèle : sur site, dans un cloud privé, dans un cloud public, dans une infrastructure en périphérie ou dans un environnement hybride.
Qu'est-ce que le MLOps ?
MLOps est l'acronyme de « Machine Learning Operations ».
Elle applique les principes du génie logiciel et du DevOps aux systèmes d'apprentissage automatique.
Le déploiement traditionnel de logiciels peut impliquer :
Codage → Test → Compilation → Déploiement → Surveillance
L'apprentissage automatique introduit des composants supplémentaires :
Données → Caractéristiques → Apprentissage → Modèle → Validation → Déploiement → Surveillance → Réapprentissage
AWS souligne que la mise en œuvre du ML en production pose des défis qui vont au-delà du développement logiciel classique, notamment l'évolution des distributions de données et la dette technique, ce qui confère une importance particulière aux pratiques opérationnelles.
Le MLOps peut aider les entreprises à gérer :
- Pipelines de données
- Gestion des versions des modèles
- Suivi des expériences
- Déploiement du modèle
- Infrastructure
- Suivi
- Reconversion professionnelle
- Gouvernance
- Rétroductions
Les recommandations d'AWS en matière de MLOps identifient également l'intégration continue, le déploiement, la surveillance, la formation et la gouvernance comme des éléments essentiels d'un processus de mise en œuvre du ML.
Modèles de déploiement de l'apprentissage automatique
Les entreprises disposent de plusieurs options de déploiement.
ML dans le cloud
Les plateformes cloud offrent des services évolutifs de calcul, de stockage et d'apprentissage automatique géré.
Parmi les avantages, on peut citer :
- Évolutivité
- Mise à disposition plus rapide
- Infrastructure gérée
- Disponibilité mondiale
Apprentissage automatique sur site
Certaines organisations doivent gérer leurs modèles au sein de leur propre infrastructure.
Cela pourrait s'expliquer par :
- Souveraineté des données
- Conformité
- Sécurité
- Infrastructure existante
- Exigences opérationnelles
Apprentissage automatique hybride
Les architectures hybrides associent des systèmes dans le cloud et sur site.
Cela peut s'avérer utile pour les entreprises qui ont besoin de flexibilité tout en conservant certaines données ou charges de travail dans des environnements contrôlés.
Edge ML
L'apprentissage automatique en périphérie exécute les modèles à proximité du lieu où les données sont générées.
En voici quelques exemples :
- Capteurs industriels
- Appareils connectés
- Appareils photo
- Véhicules connectés
Le déploiement en périphérie permet de réduire la latence et la dépendance à une connectivité permanente.
Sécurité et gouvernance de l'apprentissage automatique
L'apprentissage automatique en entreprise nécessite une sécurité tout au long de son cycle de vie.
Parmi les domaines importants, on peut citer :
Sécurité des données
Protéger les données d'entraînement et d'inférence contre tout accès non autorisé.
Contrôle d'accès
Seuls les utilisateurs et les services autorisés doivent pouvoir accéder aux modèles et aux ensembles de données sensibles.
Sécurité des modèles
Les modèles doivent être protégés contre toute modification et extraction non autorisées.
Sécurité des API
Les API d'inférence ML doivent utiliser des mécanismes appropriés d'authentification, d'autorisation et de limitation du débit.
Confidentialité des données
Les informations personnelles et professionnelles sensibles doivent être traitées conformément aux exigences en vigueur.
Traçabilité
Les entreprises doivent conserver les documents suivants :
- Versions du modèle
- Ensembles de données d'apprentissage
- Modifications
- Déploiements
- Prévisions, le cas échéant
- Interventions humaines
Le cadre de gestion des risques liés à l'IA du NIST offre un cadre facultatif pour la gestion des risques liés à l'IA et intègre des aspects tels que la validité, la fiabilité, la sûreté, la sécurité, la transparence, l'explicabilité, la protection de la vie privée et l'équité.
Apprentissage automatique explicable et responsable
Certaines décisions d'entreprise exigent davantage de transparence que d'autres.
Par exemple, un moteur de recommandation peut être soumis à des exigences en matière d’explicabilité différentes de celles d’un modèle utilisé pour étayer des décisions en matière de risques financiers.
Les entreprises devraient tenir compte des éléments suivants :
- Pourquoi le modèle a-t-il fait cette prévision ?
- Quels facteurs ont influencé ce résultat ?
- Cette décision peut-elle faire l'objet d'un réexamen par des personnes ?
- Le modèle produit-il des résultats biaisés ?
- Le modèle offre-t-il des performances constantes dans l'ensemble des groupes concernés ?
- Les prévisions problématiques peuvent-elles être remises en question ou corrigées ?
Le cadre de gestion des risques liés à l’IA (AI RMF) du NIST organise la gestion des risques autour de Gouverner, cartographier, mesurer et gérer, offrant ainsi un cadre concret aux organisations qui mettent en œuvre des pratiques responsables en matière d'IA.
Les défis du machine learning en entreprise
L'apprentissage automatique offre des perspectives considérables, mais sa mise en œuvre peut s'avérer difficile.
1. Mauvaise qualité des données
Des données erronées peuvent entraîner des prévisions peu fiables.
2. Les silos de données
Les données d'entreprise sont souvent réparties entre différents services et systèmes existants.
3. Manque d'expertise en apprentissage automatique
La réussite des projets peut nécessiter des compétences dans les domaines suivants :
- Ingénierie des données
- Science des données
- Apprentissage automatique
- Cloud
- Génie logiciel
- Sécurité
- MLOps
4. Complexité de l'intégration
Un modèle entraîné n'a qu'une valeur limitée s'il ne peut pas s'intégrer aux applications et aux flux de travail de l'entreprise.
5. Dérive du modèle
Les tendances observées dans la réalité évoluent.
Un modèle entraîné à partir de données historiques peut progressivement perdre en précision à mesure que le comportement des clients, les conditions du marché ou les processus opérationnels évoluent.
6. Coûts d'infrastructure
Les grands ensembles de données et les modèles complexes peuvent nécessiter d'importantes ressources informatiques.
7. Gouvernance
Les entreprises doivent déterminer à qui appartiennent les modèles, les données, les décisions et les risques.
IBM a indiqué en 2026 que 70% des responsables technologiques interrogés avaient déclaré que, dans l'ensemble de leur organisation, les équipes déployaient des technologies à un rythme trop rapide pour que le service informatique puisse suivre, ce qui illustre les défis en matière de gouvernance et de visibilité auxquels les entreprises sont confrontées à mesure que le déploiement de l'IA prend de l'ampleur.
Coûts liés à l'apprentissage automatique
Il n'existe pas de tarif universel pour le machine learning en entreprise.
Le coût total dépend des éléments suivants :
- Complexité du projet
- Volume de données
- Complexité du modèle
- Nombre d'intégrations
- Infrastructure cloud
- Équipe de développement
- Exigences en matière de sécurité
- Exigences en matière de conformité
- Ampleur du déploiement
- Exigences en matière de suivi
- Formation continue
Un petit système d'analyse prédictive peut nécessiter un investissement nettement inférieur à celui d'une plateforme mondiale d'apprentissage automatique en temps réel.
Il convient donc d'évaluer ce coût par rapport à valeur commerciale et coût total de possession, et pas seulement les heures de développement.
Tendances en matière d'apprentissage automatique en 2026
Le paysage du machine learning en entreprise continue d'évoluer rapidement.
1. L'apprentissage automatique s'intègre de plus en plus dans des systèmes d'IA plus larges
L'apprentissage automatique est de plus en plus souvent utilisé en parallèle avec :
- IA générative
- Modèles linguistiques à grande échelle
- Agents d'IA
- Systèmes de recherche
- Analyse traditionnelle
- Règles métier
Plutôt que de considérer chaque technologie comme un système distinct, les entreprises mettent de plus en plus en place des architectures d'IA intégrées.
L'« AI Index » 2026 de Stanford fait état d'une accélération continue des capacités en matière d'IA et d'une implication généralisée du secteur dans le développement de systèmes d'IA avancés.
2. Une attention accrue portée aux infrastructures d'IA
Les entreprises se rendent compte que le déploiement d'un modèle d'apprentissage automatique n'est qu'un élément parmi d'autres d'une stratégie d'IA.
L'infrastructure doit prendre en charge :
- Données
- Modèles
- API
- Sécurité
- Suivi
- Gouvernance
- Intégration
IBM a indiqué en 2026 que seuls 25% des dirigeants interrogés se disaient tout à fait d'accord pour affirmer que leur infrastructure informatique était en mesure de prendre en charge le déploiement à grande échelle de l'IA dans l'ensemble de l'entreprise, soulignant ainsi le déficit infrastructurel auquel les organisations doivent remédier.
3. MLOps et observabilité des modèles
À mesure que les entreprises exploitent un nombre croissant de modèles, elles doivent disposer d'une visibilité sur :
- Performances du modèle
- Qualité des données
- Latence
- Dérive
- Utilisation des infrastructures
- Modèles de prévision
- Coûts
C'est pourquoi l'observabilité des modèles revêt une importance croissante.
4. Gouvernance de l'IA
À mesure que l'apprentissage automatique s'intègre aux processus stratégiques de l'entreprise, la gouvernance devient une exigence opérationnelle plutôt qu'un simple exercice de mise en conformité.
Les entreprises doivent définir clairement les responsabilités en matière de :
- Propriété des données
- Propriété du modèle
- Évaluation des risques
- Approbation
- Suivi
- Réponse aux incidents
5. Modèles plus petits et spécialisés
Tous les problèmes rencontrés en entreprise ne nécessitent pas forcément un modèle à grande échelle.
Pour de nombreuses applications, les modèles spécialisés plus compacts peuvent présenter des avantages en termes de :
- Coût
- Latence
- Confidentialité
- Flexibilité de déploiement
- Contrôle
Cela vaut tout particulièrement pour les organisations qui traitent des informations sensibles ou qui gèrent des volumes importants de données.
6. Souveraineté en matière d'IA et d'apprentissage automatique
Les entreprises évaluent de plus en plus leur dépendance vis-à-vis des modèles externes, des fournisseurs de services cloud et des fournisseurs d'IA.
Une étude IBM réalisée en 2026 a révélé que 71% des cadres supérieurs interrogés estimaient qu'il serait difficile de changer de fournisseur ou de modèle d'IA principal, tandis que 91% ont déclaré ne pas comprendre pleinement leurs dépendances en matière d'IA entre les différents fournisseurs, modèles et infrastructures.
Cela souligne l'importance de la flexibilité architecturale et de la gestion des risques liés aux fournisseurs.
Pourquoi les entreprises ont besoin d'une stratégie d'apprentissage automatique à l'échelle de l'entreprise
Une stratégie d'apprentissage automatique doit apporter des réponses à plusieurs questions fondamentales :
Quels problèmes métier le ML devrait-il résoudre ?
Tous les processus métier ne nécessitent pas le recours au ML.
Quelles données peuvent être utilisées ?
La disponibilité et la qualité des données déterminent souvent la faisabilité.
Quels modèles faut-il utiliser ?
Le choix du modèle doit s'adapter au problème, et non l'inverse.
Où les modèles seront-ils exécutés ?
Les environnements cloud, sur site, hybrides ou en périphérie peuvent chacun convenir à différentes charges de travail.
Comment les modèles seront-ils contrôlés ?
Le ML en production nécessite une observabilité continue.
À qui appartient le système ?
Les responsabilités doivent être clairement définies.
Comment les risques seront-ils gérés ?
La sécurité, la confidentialité, les biais, l'explicabilité et la conformité doivent être pris en compte tout au long du cycle de vie.
Pourquoi choisir RailsCarma pour le développement d'applications d'apprentissage automatique ?
Pour les entreprises, développement en apprentissage automatique Ce n'est pas simplement un exercice de science des données. Cela nécessite la capacité d'établir des liens données, modèles et applications métier pour en faire un système de production fiable.
RailsCarma’s Une formation en génie logiciel peut aider les organisations qui souhaitent intégrer l'apprentissage automatique dans leurs produits numériques existants et leurs processus métier.
Une mise en œuvre concrète du ML en entreprise peut inclure :
- Conseil en apprentissage automatique
- Élaboration d'une stratégie et d'une feuille de route en matière d'apprentissage automatique
- Ingénierie des données
- Analyse prédictive
- Modèles d'apprentissage automatique personnalisés
- Moteurs de recommandation
- Solutions de prévision
- Détection des fraudes et des anomalies
- Développement d'applications basées sur l'IA
- Développement de l'API ML
- Déploiement du ML dans le cloud
- Mise en œuvre de MLOps
- Suivi des modèles
- Intégration d'applications héritées
L'objectif principal devrait être de développer des solutions d'apprentissage automatique qui s'intègrent dans l'écosystème technologique existant de l'organisation, plutôt que de créer des modèles isolés qui restent cantonnés au stade de l'expérimentation.
Pour les entreprises qui disposent déjà d'un site web et applications mobiles, l'apprentissage automatique peut être intégré via des API et des services backend afin que l'intelligence prédictive s'intègre aux flux de travail existants.
Liste de contrôle pour la mise en œuvre de l'apprentissage automatique dans les entreprises
Avant de se lancer dans un projet d'apprentissage automatique, les organisations peuvent s'appuyer sur cette liste de contrôle :
Affaires
- Y a-t-il un problème métier clairement défini ?
- Existe-t-il des indicateurs clés de performance (KPI) mesurables ?
- Le ML est-il vraiment nécessaire ?
- Y a-t-il un chef d'entreprise identifié ?
Données
- Dispose-t-on de données historiques suffisantes ?
- Ces données sont-elles exactes ?
- Ces données sont-elles légalement exploitables ?
- Les problèmes liés à la qualité des données sont-ils bien compris ?
Technologie
- Existe-t-il des infrastructures adaptées ?
- Ce modèle peut-il s'intégrer aux applications existantes ?
- Une API ou une architecture par lots est-elle nécessaire ?
- La solution est-elle évolutive ?
ML
- Le problème d'apprentissage automatique est-il clairement défini ?
- Les indicateurs d'évaluation appropriés ont-ils été choisis ?
- Le modèle a-t-il été validé sur des données non vues ?
- Le surapprentissage a-t-il été évalué ?
Opérations
- La surveillance des modèles est-elle mise en place ?
- Existe-t-il un système de gestion des versions pour les modèles ?
- La notion de « reconversion professionnelle » est-elle définie ?
- Existe-t-il une procédure de restauration ?
Sécurité
- Des contrôles d'accès ont-ils été mis en place ?
- Les données sensibles sont-elles protégées ?
- Les API sont-elles sécurisées ?
- Existe-t-il des journaux et des pistes d'audit ?
Gouvernance
- La notion de « propriété du modèle » est-elle définie ?
- Les risques sont-ils consignés ?
- Des processus de vérification humaine sont-ils nécessaires ?
- Les exigences réglementaires sont-elles bien comprises ?
Conclusion
L'apprentissage automatique est devenu un élément essentiel des stratégies technologiques des entreprises modernes. Cependant, la réussite de la mise en œuvre de l'apprentissage automatique ne se résume pas au simple choix d'un algorithme sophistiqué.
Tout commence par un problématique métier clairement définie, se poursuit par la collecte de données fiables et l'élaboration de modèles adaptés, puis s'étend au déploiement, à l'intégration, au suivi, à la gouvernance et à l'amélioration continue.
Les principes fondamentaux restent simples :
Problématique métier → Données → Modèle → Validation → Déploiement → Suivi → Amélioration
Ce qui rend l'apprentissage automatique en entreprise si difficile, c'est l'ampleur et la complexité de ces différentes étapes.
En 2026, les organisations devraient donc aborder l'apprentissage automatique comme un une capacité technologique à long terme plutôt qu'une expérience ponctuelle. La mise en place de bases de données solides, l'adoption de pratiques MLOps, la mise en œuvre d'une gouvernance adaptée et l'intégration du ML dans les systèmes d'entreprise existants peuvent permettre de tracer une voie plus durable, de l'expérimentation à la mise en production.
Pour les organisations qui planifient la prochaine étape de leur adoption de l'IA et de l'apprentissage automatique, la priorité devrait être d'identifier des cas d'utilisation concrets dans lesquels l'intelligence prédictive peut générer des résultats commerciaux mesurables, tout en garantissant un niveau adéquat de sécurité, de transparence et de contrôle opérationnel.
Foire aux questions sur les principes fondamentaux de l'apprentissage automatique
1. Qu'est-ce que l'apprentissage automatique, en termes simples ?
L'apprentissage automatique est une technologie qui permet aux ordinateurs d'identifier des modèles à partir de données et d'utiliser ces modèles pour établir des prévisions ou prendre des décisions sans qu'il soit nécessaire de programmer manuellement chaque règle.
2. Quelle est la différence entre l'IA et l'apprentissage automatique ?
L'intelligence artificielle désigne, au sens large, la création de systèmes capables d'effectuer des tâches associées à l'intelligence. L'apprentissage automatique est une approche de l'IA qui permet aux systèmes d'apprendre à partir de données.
3. Quels sont les principaux types d'apprentissage automatique ?
Les principales catégories sont l'apprentissage supervisé, l'apprentissage non supervisé, l'apprentissage semi-supervisé et l'apprentissage par renforcement.
4. Comment les entreprises utilisent-elles l'apprentissage automatique ?
Les entreprises utilisent l'apprentissage automatique (ML) pour des applications telles que la détection des fraudes, les prévisions, la segmentation de la clientèle, les recommandations, la maintenance prédictive, la prévision du taux de désabonnement, la détection des anomalies et l'analyse des risques.
5. L'apprentissage automatique nécessite-t-il de grandes quantités de données ?
Pas nécessairement. La quantité de données nécessaire dépend du problème, du modèle et de la qualité des données disponibles. Certaines applications peuvent fonctionner efficacement avec des ensembles de données relativement petits, tandis que des applications complexes peuvent nécessiter des ensembles de données très volumineux.
6. Qu'est-ce que le MLOps ?
Le terme « MLOps » désigne les pratiques et les technologies utilisées pour gérer le cycle de vie de l'apprentissage automatique, notamment le développement, le déploiement, la surveillance, la gestion des versions et le réentraînement des modèles.
7. Pourquoi la qualité des données est-elle importante dans l'apprentissage automatique ?
Les modèles d'apprentissage automatique s'appuient sur des données pour apprendre. Des données inexactes, incomplètes, biaisées ou non pertinentes peuvent conduire à des prévisions peu fiables.
8. Qu'est-ce que la dérive du modèle ?
On parle de « dérive du modèle » lorsque des changements dans les données ou les relations du monde réel entraînent une dégradation progressive des performances d'un modèle déployé.
9. L'apprentissage automatique est-il sûr ?
L'apprentissage automatique n'est pas en soi automatiquement sécurisé. Les systèmes d'apprentissage automatique d'entreprise nécessitent des mesures de sécurité couvrant les données, l'infrastructure, les API, les modèles, les accès, la surveillance et la gouvernance.
10. Combien coûte le machine learning en entreprise ?
Les coûts varient considérablement en fonction des besoins en données, de la complexité des modèles, des intégrations, de l'infrastructure, de la sécurité, de l'effort de développement et de l'ampleur du déploiement. Une démonstration de faisabilité peut coûter nettement moins cher qu'une plateforme d'apprentissage automatique en production fonctionnant sur plusieurs systèmes d'entreprise.
11. Toutes les entreprises devraient-elles adopter l'apprentissage automatique ?
Tous les processus métier ne nécessitent pas le recours à l'apprentissage automatique. Les entreprises doivent d'abord identifier les problèmes mesurables pour lesquels les prévisions ou l'automatisation fondées sur les données peuvent apporter une réelle valeur ajoutée.
12. Comment une entreprise peut-elle se lancer dans l'apprentissage automatique ?
Une bonne approche consiste à identifier un problème métier mesurable et à forte valeur ajoutée, à évaluer les données disponibles, à mettre au point une preuve de concept, à valider la valeur métier, puis à développer l'architecture de production et les capacités MLOps nécessaires à la mise à l'échelle.

 French
 English
 Japanese
 German
 Spanish
 Italian
 Swedish